
OpenAI BioBasicsBench, AI ajanlarını 100 rutin laboratuvar görevinde ölçüyor
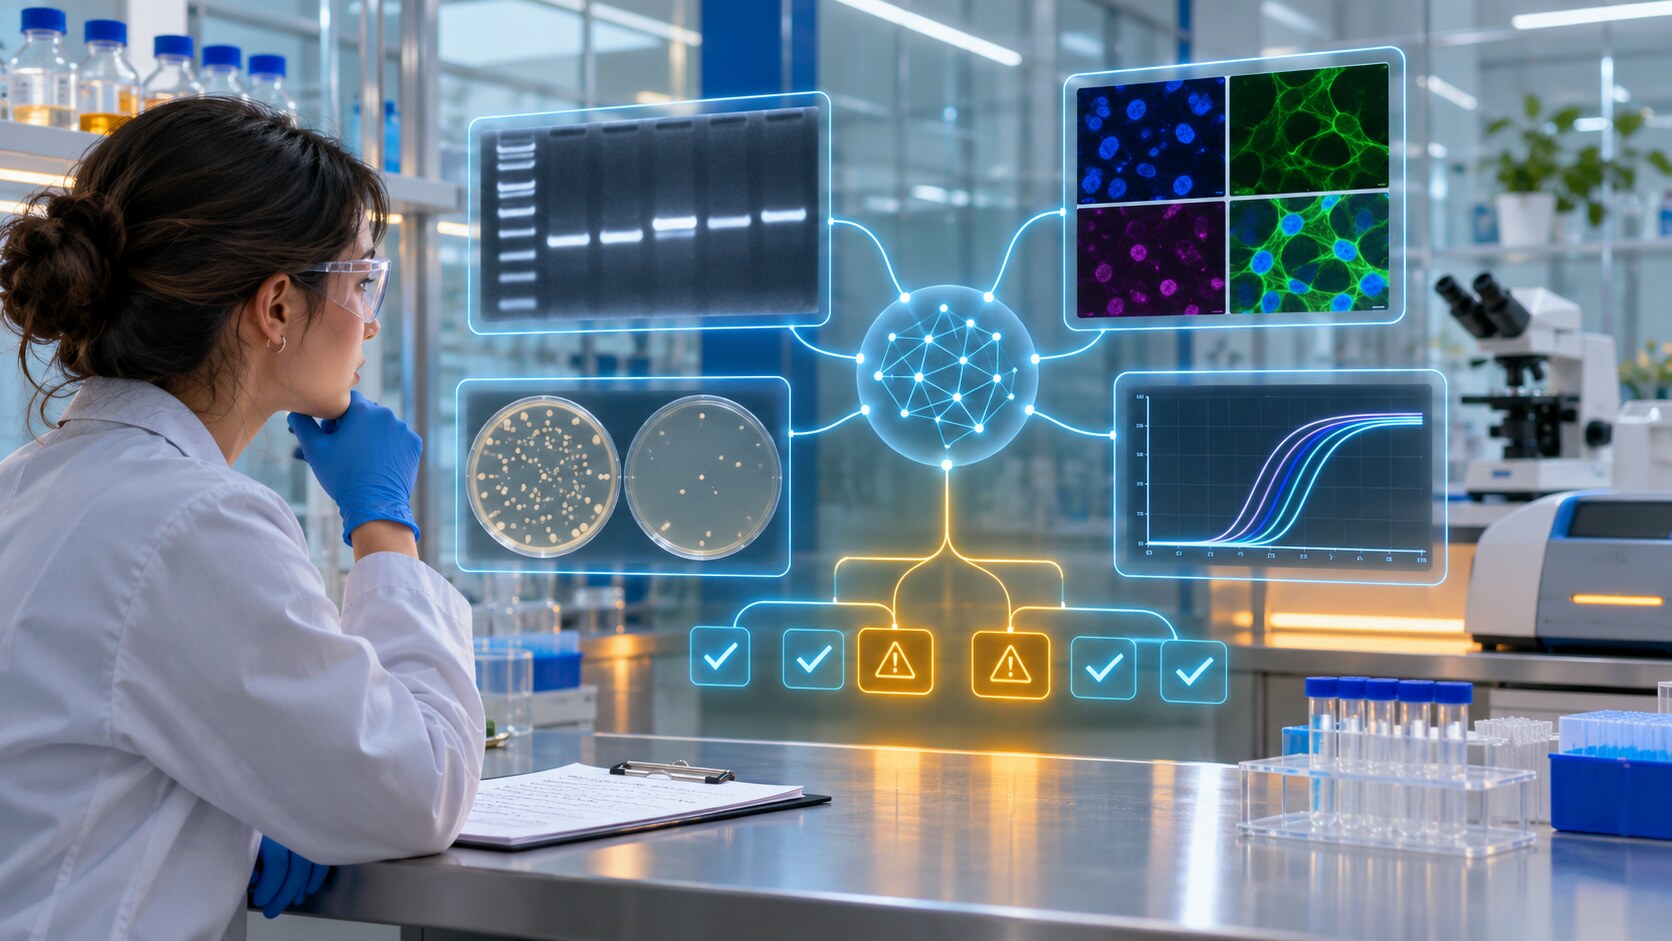
OpenAI ve Ligo’nun BioBasicsBench değerlendirmesi, AI ajanlarının ham deney verisini yorumlama, hataları yakalama ve kanıtın sınırını tanıma becerisini 100 rutin ıslak laboratuvar göreviyle ölçüyor.
BİR BAKIŞTA
Haberin özeti
- BioBasicsBench, beş rutin laboratuvar alanına yayılan 100 görev içeriyor.
- Yedi model, 37 ayarda toplam 18.500 denemeyle ölçüldü.
- xhigh ayarında GPT‑6 Astra yüzde 66,7, GPT‑5.6 Sol yüzde 43,8 ortalama kredi aldı.
Neler değişiyor?
OpenAI, enzim tasarım şirketi Ligo ile geliştirdiği BioBasicsBench değerlendirmesini yayımladı. Sistem, AI ajanlarının jel görüntüleri, koloni plakaları, mikroskopi kayıtları, dizileme dosyaları ve cihaz çıktıları gibi ham deney kanıtlarını yorumlayıp yorumlayamadığını 100 rutin görev üzerinden ölçüyor.
Görevler protein yöntemleri, görüntüleme ve sitometri, nicelleştirme ve testler, nükleik asit yöntemleri ile moleküler klonlama olmak üzere beş alana yayılıyor. Ajanların yalnız sonuç vermesi değil; hatalı kontrolleri, belirsiz görüntüleri ve kanıtın bir sonuca yetmediği durumları tanıması da puanlanıyor.
OpenAI yedi modeli 37 model/akıl yürütme ayarında ve toplam 18.500 denemede değerlendirdi. En yüksek ortak akıl yürütme ayarı xhigh’da GPT‑6 Astra yüzde 66,7, GPT‑5.6 Sol ise yüzde 43,8 ortalama kredi aldı. Şirket sonuçların ilerleme gösterdiğini, ancak görüntü yorumlama, kontrol denetimi ve deney bağlamında açıklar kaldığını belirtiyor.
Asıl kaynaklara göz at
Kaynak tarihi: 6 Kasım 2026.
AI Radar yayın saati: 6 Kas 2026 23:07 (Türkiye).
KONUYU TAKİP ET
Konular ve etiketler
Keşfini paylaş.
Bu haberi bir arkadaşına gönder.
Okuyucu yorumları
Bu gelişme hakkında ne düşünüyorsun? Deneyimini veya sorunu paylaş. Yorumlar editör onayından sonra yayımlanır.
Adın/takma adın ve yorumun onaylanırsa herkese açık görünür. Veri işleme hakkında: Gizlilik bilgilendirmesi.



Yorumlar yükleniyor…